搜索曲线上升,首先证明系统找到了高分
自我改进系统通常每轮产生多个候选,再保留最高分。即使每个候选的真实能力完全相同,测量噪声也会让其中一些表现特别好。候选越多,赢家越容易成为幸运样本。
这不是指控某篇 RSI 论文的收益来自噪声,而是评价所有搜索系统之前应理解的统计结构。RRSI 用成本、历史与噪声带组织准入,Hyperagents 增加改进器迁移实验;二者都提示我们,应把原任务分数、未见任务表现和未来改进能力分开。RRSI、Hyperagents
下面先构造一个没有真实学习的实验,让问题可以被单独看见,然后再回到真实系统。
合成实验的预设与边界
实验在运行前固定如下协议,执行日期为 2026-10-03。
| 项目 | 固定值 |
|---|---|
| 假设 | 只增加候选数量,就能抬高开发集赢家分数 |
| 真实能力 | 所有候选每题成功概率均为 0.60 |
| 开发测量 | 每个候选 60 次独立 Bernoulli 试验 |
| 锁定测试 | 每个候选 500 次独立 Bernoulli 试验,完全不参与选择 |
| 候选数 | 1、8、32、128,使用同一批候选的前缀 |
| 选择 | 开发分数最高者;平分时选择最早候选 |
| 重复 | 1,000 次,保留所有重复 |
| 随机种子 | 20261003,NumPy default_rng |
| 停止条件 | 预定四组完成即停止,不按结果调整参数 |
本实验用独立随机测量代表有限样本误差。真实 harness 的候选可能高度相关,任务难度也不相同,后续候选还会依赖之前反馈。本实验没有模拟这些复杂性;它隔离的是选择偏差的最小机制,不是 RRSI、DGM 或任何模型的复现。
“锁定测试”在代码里可预先生成,但只有开发集选出索引之后才读取对应测试分数。提前生成不造成泄漏;是否用于决策才是关键。四种候选数量共用前缀,因此是配对设计,不能称为四组独立实验。
同样的能力,越来越好看的赢家
下表是实际本地运行结果。所有分数单位为百分比,开发与测试差值单位为百分点。
| 候选数 | 开发集赢家均分 | 锁定测试均分 | 开发−测试 |
|---|---|---|---|
| 1 | 59.92 | 60.03 | −0.11 |
| 8 | 68.93 | 60.10 | 8.82 |
| 32 | 72.81 | 60.01 | 12.81 |
| 128 | 75.85 | 60.05 | 15.80 |
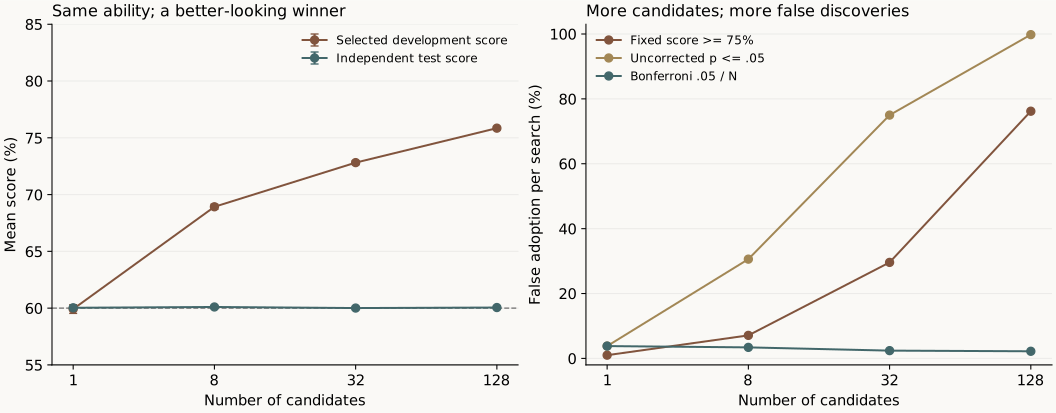
图由实验脚本使用 Matplotlib 生成。左图误差条为均值的 ±1.96 个 Monte Carlo 标准误;它描述这次重复模拟对均值的估计精度,不是单个候选的成功率区间。右图是每次搜索中至少一个候选错误通过门槛的频率。
候选数为 128 时,开发−测试差值的 Monte Carlo 标准误约 0.10 个百分点。这说明 15.80 点差距不是这一千次重复偶然凑出的平均值,但仍不涉及真实模型的泛化估计。
数学上很直观:单次估计可以无偏,但最大值不是无偏估计。如果 Sᵢ = p + εᵢ,那么选中的是较大的 εᵢ,通常有 E[max Sᵢ] > p。在近似独立、高斯误差等简化条件下,最大噪声的尺度随候选数的对数平方根增加;实际有限二项分数有上界,不能把这个近似无限外推。
设置一个涨分阈值够不够
实验比较三种准入规则。因为所有候选真实能力都没有提高,任何接受“发现了更强候选”的决定都是错误采纳。
- 固定分数门槛:开发分数至少 75%,即 60 次中至少成功 45 次。
- 未校正检验:单侧精确二项 p 值不超过 0.05,零假设为成功概率不高于 0.60。
- Bonferroni:每个候选使用 0.05/N 的 p 值门槛。
| 候选数 N | 固定 75%门槛 | 未校正 p≤0.05 | Bonferroni |
|---|---|---|---|
| 1 | 1.0% | 3.8% | 3.8% |
| 8 | 7.1% | 30.6% | 3.4% |
| 32 | 29.6% | 75.0% | 2.4% |
| 128 | 76.2% | 99.8% | 2.2% |
这里的分母是 1,000 次完整搜索,不是候选总数。固定门槛的单次误报率与 0.05 检验不同,所以不能把两列差异都归因于是否做了多重校正;未校正与 Bonferroni 两列才构成同一检验的直接对照。
脚本还用解析概率检查模拟:若独立候选单次越线概率为 q,N 个候选中至少一个越线的概率为 1−(1−q)^N。N=128 的 Bonferroni 理论值约为 3.55%,模拟为 2.2%,模拟频率的 Wilson 95%区间约 1.46%–3.31%。有限 Monte Carlo 样本可以偏离理论值;95%区间也并非保证每次包含真值。完整结果保留理论值、标准误和区间,避免只展示最漂亮的一列。
Bonferroni 不要求各候选独立,但要求每个原始 p 值本来就是有效的。本实验预先生成候选,满足所用检验的设定。真实系统根据同一个开发集反馈不断生成新候选,可能破坏原始 p 值的有效性;不能把 0.05/N 当成适应性搜索的通用修复。
真实 RSI 的评价应隔离三个层次
开发层负责让系统发现问题。可以反复查看轨迹、生成补丁、调整提示,但这些任务已经参与适应过程。
验证层用于选择候选和决定停止。它也会随着使用次数增加而泄露信息;即使从不展示标准答案,反复返回分数仍会影响选择。
锁定测试层只用于预定的最终测量。若看完测试分数又修改系统,这个测试集就参与了开发。改进后的最终评估需要新数据或重新明确证据等级。
对 meta agent 还需更进一步:让新旧改进器从相同初始系统出发,在相同预算下生成候选,比较未见任务上的后代。否则,更好的起点、更大的预算与更好的改进机制会混在一起。
评价器也不能成为候选可修改的评分入口。候选当然可以改自己的诊断方法,但正式验收规则、隐藏答案和记分程序要处于实验边界之外。这个隔离既是系统工程问题,也是结论可信度的前提。
总成本应覆盖整个改进过程
每题推理 token 只覆盖最终系统的使用成本。一次搜索还可能包含失败候选、分析模型、critic、编译、训练、重试和最后的留出验证。
建议把总账拆成:
搜索成本 = 候选生成 + 候选执行 + 筛查 + 内层训练 + 失败重试
验证成本 = 基线重测 + 锁定测试 + 迁移实验
部署成本 = 最终系统每次调用成本 × 使用次数
除了固定候选数,还要比较固定总 token、固定墙钟时间和固定硬件预算。三种约束不能互相替代:并行化能减少时间,却不一定减少计算量;训练后的模型推理更便宜,也可能需要很高的前期搜索投入。
还应保留分母。超时、未提交和基础设施故障要分别记录。基础设施故障可能使实验无结论,任务失败则进入相应任务的成功率;简单删除所有失败运行会系统性抬高结果。
开放研究为何需要另一类测试
可执行代码任务可以提供清楚的局部反馈。真实研究还需要判断问题是否值得做、方法是否新颖、负面实验意味着什么,以及何时停止一条路线。
2026 年的《Can AI agents conduct open-ended AI research?》采用 shadow evaluation:把尚未公开投稿的研究问题交给 Agent,再由原作者深入评审。主要设置给予六天、3,000 美元 API 预算及 GPU 资源;两项研究最终 overall 评分为 2/6 和 1/6,均被拒。原文 v2
这组实验的意义是把工程执行与研究判断分开。Agent 可以完成真实代码和实验,但是否构成可靠、原创、有说服力的研究,还涉及数据选择、基线、资源分配和对失败的解释。
它也只有两道研究问题,且存在作者兼评价者、harness 故障与预算设置等边界。结论是这些具体运行未达到目标,不能推广成所有 RSI 都无效。相反,任务成功的局部论文也不能自动推广成已经能完成开放研究。
可复现材料与验收记录
本地环境:Python 3.14.6、NumPy 2.5.3、Matplotlib 3.11.2。脚本不调用模型 API,不读取网络或真实模型数据。安装这三个版本后运行:
python experiment.py --output results执行检查包括:独立测试均值与真实 p 相容;前缀候选增多时开发赢家均分不下降;Bonferroni 理论族错误率不超过 0.05;模拟误采纳率在预设容差内接近解析概率。没有据结果更换种子或丢弃重复。
这组实验只证明一个有限结论:选择过程会改变分数的解释方式。 对真实自我改进最有价值的证据,是能力与改进方法在明确资源条件下,经未参与选择的任务仍能成立,并且完整过程可被独立检查。
更新于 2026-10-03 · 研究方法